Определите задачу аудита
Отчёт на несколько сотен предупреждений ещё не объясняет, почему важные страницы не появляются в поиске. Последствия у ошибок разные: запрет индексации целого раздела обычно важнее неудачного заголовка одной статьи. Задача технического SEO-аудита — найти причину проблемы, показать, какие страницы она затрагивает, и подготовить задания на исправление.
Сначала сформулируйте задачу: проверить новый сайт перед продвижением, найти причину исчезновения раздела из поиска или оценить последствия смены шаблона. Запишите дату заметного изменения и перечень затронутых страниц. Это поможет не смешивать техническую ошибку с сезонностью спроса, изменением контента или рекламной активности.
Определите, какие страницы должны получать посетителей из поиска. Для сайта услуг это могут быть главная, страницы направлений, кейсы и статьи. Для личного кабинета, внутреннего поиска и служебных адресов заранее определите, нужно ли их вообще показывать в поиске. Отсутствие такой страницы в индексе, то есть поисковой базе, само по себе не означает неисправность.
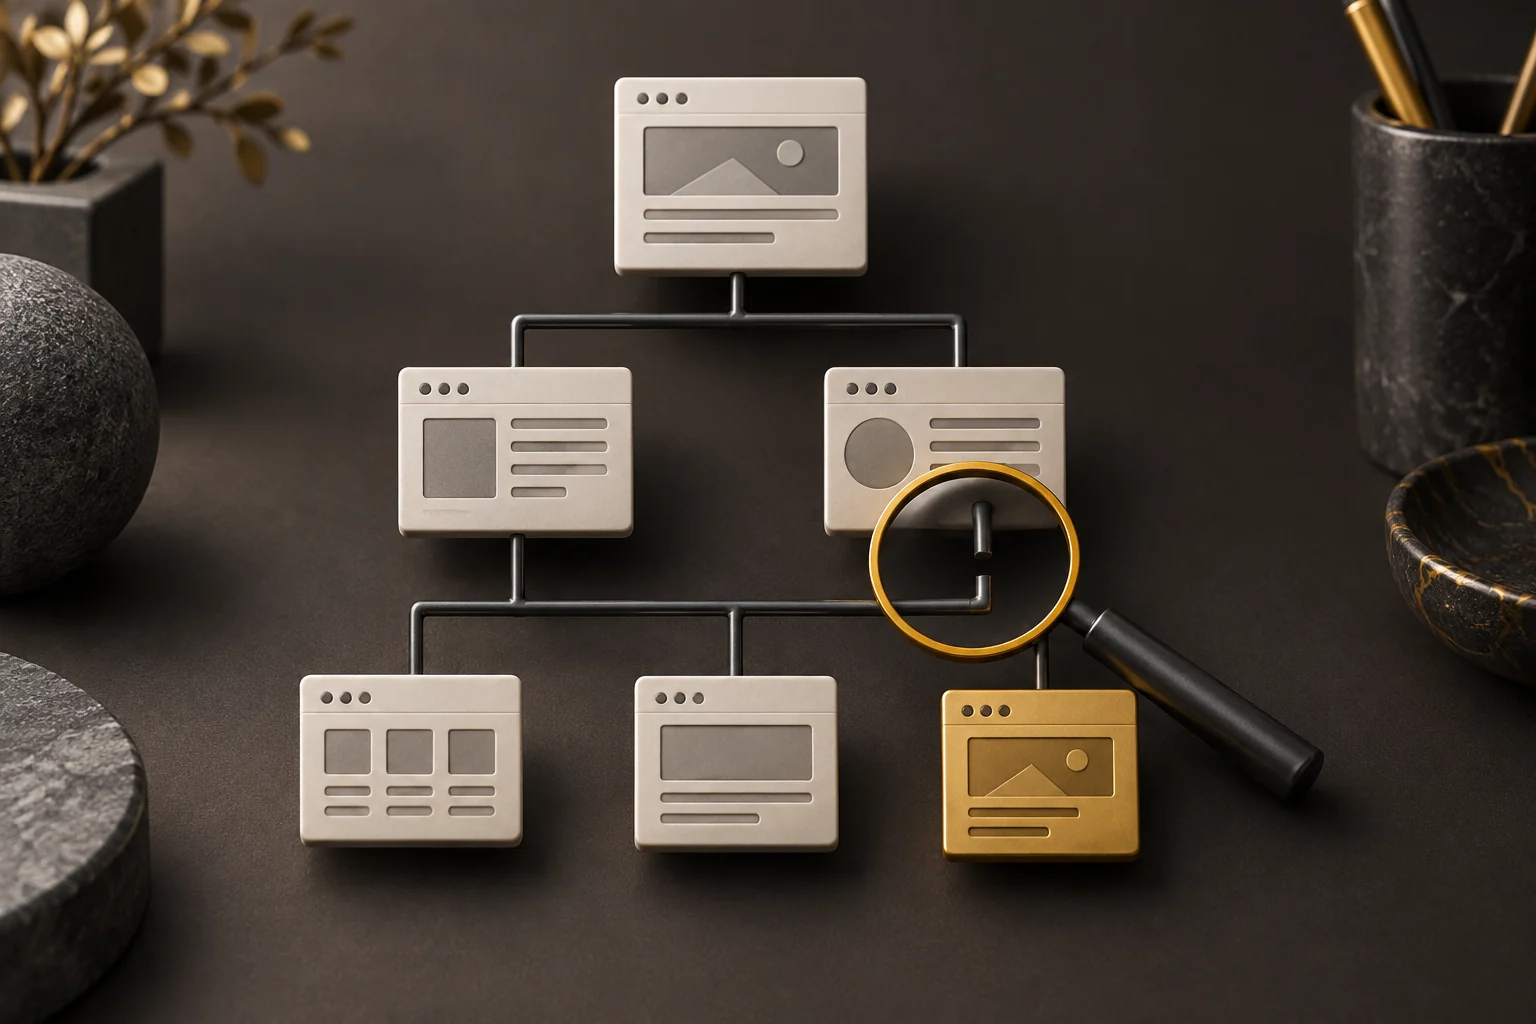
Соберите адреса страниц (URL) из нескольких источников: структуры сайта, карты Sitemap, системы управления, аналитики и инструментов для вебмастеров. Запишите, где получен каждый URL, когда он проверен и к какому типу относится. Для большого сайта сначала выделите шаблоны, а затем добавьте исключения: страницы с параметрами, старые адреса и недавно изменённые разделы.
Подготовьте исходные данные и контрольную выборку
Для первичной проверки достаточно открытых страниц и браузера. Доступ к Яндекс Вебмастеру, Google Search Console и аналитике позволит сравнить внешние наблюдения с данными сайта. Журналы сервера и настройки приложения понадобятся, если ошибка непостоянна или возникает только при определённых запросах к серверу.
Включите в выборку по нескольку страниц каждого значимого шаблона: услугу, статью, категорию, карточку товара, если она есть. Добавьте страницу с хорошей видимостью, проблемную страницу и новый материал. Один удачный пример не подтверждает исправность всего раздела.
При обходе сайта программой ограничьте скорость запросов и согласуйте запуск с администратором. На рабочем сервере не стоит одновременно проверять бесконечные комбинации фильтров или адреса, запускающие действия. Заранее задайте область обхода и исключения, чтобы программа проверила нужные разделы и не создала лишнюю нагрузку.
- Сохраните исходный URL и адрес после всех перенаправлений.
- Зафиксируйте код ответа, тип страницы и дату проверки.
- Отметьте запреты индексирования и canonical — указанный предпочтительный адрес страницы.
- Запишите источники внутренних ссылок и наличие адреса в Sitemap.
- Добавьте статус из инструментов поисковых систем, если он доступен.
Проверьте доступность и конечные адреса страниц
Откройте важные URL и посмотрите ответы сервера. Рабочая страница должна отдавать свой контент с подходящим кодом; удалённая — сообщать об отсутствии, а перенесённая — вести на уместную замену. Отдельно проверяйте произвольный несуществующий адрес: некоторые сайты показывают шаблон ошибки, но отвечают как на успешный запрос.
По документации Google по HTTP-кодам, ответ 200 не гарантирует индексирование, а пустая страница или сообщение об ошибке при успешном ответе могут распознаваться как soft 404. Ошибки сервера 5xx и ограничение запросов 429 также требуют отдельной проверки. Проверяйте содержимое ответа вместе с его кодом.
Для перенаправлений запишите всю цепочку и конечный адрес. Например, переход со старого адреса на HTTP-версию, затем на HTTPS и потом на новый раздел усложняет маршрут. Если постоянный перенос уже согласован, разработчику можно поставить задачу направить исходный URL сразу на актуальную страницу и обновить внутренние ссылки.
Если сайт периодически недоступен, сохраните время ошибки и повторите запрос из другого подключения. Администратору передайте URL, код и обстоятельства, чтобы сопоставить их с журналами сервера. Одна успешная загрузка не исключает сбоя во время обхода роботом.
Сравните список страниц сайта с данными поисковых систем
Для анализа удобно держать рядом три списка: страницы, которые бизнес хочет показывать в поиске; страницы, найденные при обходе сайта; страницы, известные поисковой системе. При расхождении найдите конкретные адреса и выясните, почему они отсутствуют в одном из списков.
Если важная услуга присутствует в Sitemap, но на неё нет внутренних ссылок, проверьте путь из меню и тематических разделов. Если адрес обнаружен при обходе, но не нужен посетителям из поиска, уточните назначение страницы. Если нужного URL нет в поиске, изучите конкретную причину и дату последнего обхода, а не только общее количество исключённых адресов.
Проверяйте по порядку: может ли робот запросить страницу, получает ли он её содержимое и включена ли она в поисковую базу. Доступная страница не обязательно попадёт в индекс. Для каждого проблемного URL сохраняйте факты отдельно от предполагаемой причины.
На сайтах с JavaScript сравните исходный ответ сервера, страницу после выполнения скриптов и результат проверки в поисковом инструменте. Основной текст, ссылки и метаданные могут появляться на разных этапах. В руководстве Google по JavaScript SEO объясняется обработка такого контента; выводы по Google не следует автоматически переносить на любой другой поисковый робот.
Проверьте также мобильное представление. Важный текст, ссылка на услугу и форма не должны исчезать из-за ошибки шаблона. Для визуальной части пригодится порядок проверки адаптивности. Поисковые инструменты и проверка в браузере дополняют друг друга.
Три списка URL для проверки полноты
Нужные бизнесу страницы
Какие услуги, категории и статьи должны быть доступны пользователям и поиску?
Найденные при обходе
Какие страницы обнаруживаются по внутренним ссылкам и какой ответ возвращают?
Известные поисковой системе
Какие URL и причины исключения показывают инструменты вебмастера?
Разберите robots.txt, noindex, canonical и Sitemap по отдельности
Эти механизмы решают разные задачи. Не исправляйте их одним правилом для всего сайта: сначала выясните, какие адреса должны быть доступны для обхода и какие версии страниц должны участвовать в поиске.
Запрет обхода и запрет индексирования
Проверьте правила robots.txt для важных разделов и ресурсов, необходимых для отображения. Затем отдельно проверьте метатег robots и HTTP-заголовок X-Robots-Tag. Частая ошибка после запуска — сохранившийся запрет, который предназначался для тестовой копии.
Google должен получить страницу, чтобы увидеть правило noindex. Поэтому одновременная блокировка её обхода в robots.txt мешает обнаружить это правило. Такая зависимость прямо описана в документации Google о noindex. В отчёте укажите обе настройки и ожидаемый результат, а не совет «закрыть дубли» без способа проверки.
Канонический адрес
Для страниц с одинаковым или близким содержанием проверьте rel="canonical": куда он ведёт, доступна ли целевая страница и совпадает ли её назначение с исходной. Не ставьте canonical всех статей на главную блога. Это разные материалы, а не версии одной страницы.
Яндекс рассматривает canonical как рекомендацию и может её не принять, например при существенном различии контента или недоступности целевого адреса. После повторного обхода посмотрите в инструментах вебмастера, какую версию страницы выбрала поисковая система.
Карта сайта
Сопоставьте Sitemap с согласованным списком значимых канонических URL. Найдите перенаправления, ошибки ответа и адреса, которые закрыты от индексирования. В справке Яндекса по Sitemap указано, что карта сообщает о структуре сайта, но не гарантирует появление всех перечисленных страниц в поиске.
Проверьте, что внутренние ссылки, canonical и Sitemap указывают на одну нужную версию страницы, а правила обхода и индексирования позволяют поисковику её обработать. Правила для фильтров, пагинации и параметров согласуйте по типам страниц, прежде чем менять шаблон.
Проверьте метаданные, разметку и внутренние ссылки
Оценивайте ошибки не только постранично, но и по шаблонам. Если у нескольких услуг одинаковый title или в нём осталось имя тестового проекта, причина может находиться в общей настройке. В таком случае исправьте общую настройку. Ручные изменения на отдельных страницах могут исчезнуть при следующем обновлении шаблона.
Title — заголовок страницы в HTML — должен понятно обозначать её тему. H1 служит главным заголовком в тексте, а метатег description кратко описывает содержание. Не считайте фиксированное число символов универсальной границей качества. Сначала уберите обрывы, чужие названия, бессмысленные повторы и одинаковые описания разных материалов.
Google формирует заголовок результата из нескольких источников и может изменить предложенный текст; это описано в рекомендациях по ссылкам-заголовкам. Описание результата также не обязано дословно повторять description: сниппет может строиться из содержимого страницы.
Проверьте, можно ли дойти до важного материала по обычным ссылкам. Найдите ссылки на несуществующие страницы, лишние перенаправления и материалы, доступные только через поиск по сайту. Google рекомендует использовать ссылки с элементом a и атрибутом href. Рабочая кнопка в браузере ещё не подтверждает, что навигация устроена подходящим для обхода способом.
Если на странице есть структурированные данные, сравните их с видимым содержимым: название, автор, цена или дата должны совпадать с тем, что получает пользователь. Проверьте подходящий тип разметки и ошибки валидатора. Корректная разметка не гарантирует расширенный результат Google, поэтому обещать его после внедрения нельзя.
Отделяйте критические ошибки от улучшений
Приоритет определяют последствия, масштаб и уверенность в причине. Закрытый от индексирования раздел ключевых услуг обычно требует внимания раньше, чем неидеальное описание одной статьи. Но предупреждение программы ещё нужно подтвердить: намеренно исключённый служебный адрес не следует открывать ради улучшения оценки.
Для каждой находки ответьте: какие нужные страницы затронуты, что именно не работает, какими данными это подтверждено и что изменится после исправления. Если доказательств пока нет, назовите пункт гипотезой и предложите проверку. В таком виде разработчик сможет сначала воспроизвести проблему и только потом менять настройки.
| Условная находка | Доказательство и URL | Риск и проверка исправления |
|---|---|---|
| На страницах услуг остался noindex | Тег в ответе страниц одного шаблона; список адресов приложен | Нужные страницы запрещены к индексированию. После правки проверить ответ и затем повторный обход |
| Ссылки из каталога ведут на 404 | Исходные страницы, адреса переходов и коды ответа | Прерван путь к товарам. Повторить обход затронутого шаблона и открыть целевые страницы |
| Canonical указывает на чужую услугу | HTML-тег и сравнение содержания двух страниц | Сигналы о предпочитаемом URL противоречивы. Проверить шаблон и последующий выбор канонической страницы |
| У разных статей одинаковый description | Список совпадений и тексты страниц | По описанию невозможно различить материалы. Исправить шаблон или тексты и повторить выборочную проверку |
В таблице приведены условные примеры задач. Для своего сайта уточните приоритет по числу затронутых страниц и их роли в привлечении посетителей.
Скорость загрузки и удобство на телефоне включайте в план отдельными проверками. Подробная диагностика производительности требует условий измерения и анализа причины, поэтому её лучше вынести в самостоятельную задачу, чем добавлять рекомендацию «ускорить сайт» без исходных данных.
В каком порядке передавать исправления
Доступ и индексирование
Сначала восстановите доступ к важным страницам и устраните ошибочные запреты.
Ошибки общих шаблонов
Затем исправьте причины, которые повторяются на множестве URL: ссылки, canonical, редиректы.
Следующие улучшения
После критичных исправлений оцените остальные рекомендации и подтвердите результат повторной проверкой.
Как передать исправления в работу
У каждой задачи должны быть ответственный, затронутый шаблон или список URL, ожидаемое поведение и критерий приёмки. Приложите пример ошибочного ответа или фрагмент настройки. Формулировка «исправить SEO» не объясняет разработчику, что менять и как доказать результат.
Изменения общих правил сначала проверяйте на тестовой копии или ограниченном наборе страниц. Сохраните прежнюю конфигурацию и порядок возврата. Особенно это важно для перенаправлений, robots.txt и шаблонов canonical: одно изменение может затронуть весь сайт.
Повторный обход проводите на том же наборе URL и в сопоставимых условиях. Добавьте несколько соседних страниц, чтобы убедиться, что исправление не создало новую проблему. Отметьте дату выпуска, версию изменения и результат проверки; нерешённые пункты оставьте с пояснением.
В конце аудита составьте три списка: подтверждённые ошибки для исправления, вопросы для дополнительной проверки и необязательные улучшения. Передайте команде короткий список приоритетов и доказательства по каждому пункту. Если нужен разбор вашего сайта, отправьте адрес и описание задачи — начнём с нужных страниц и доступных данных.
Источники и полезные ссылки
- Google: HTTP-коды и обработка страниц поисковыми роботами ↗
- Google: основы JavaScript SEO ↗
- Google: запрет индексирования с помощью noindex ↗
- Яндекс Вебмастер: канонический адрес страницы ↗
- Яндекс Вебмастер: файл Sitemap ↗
- Google: формирование заголовков результатов поиска ↗
- Google: описания и сниппеты ↗
- Google: доступные для обхода ссылки ↗
- Google: общие требования к структурированным данным ↗
Интерфейсы и возможности сервисов могут меняться. Перед настройкой сверяйтесь с актуальной документацией.